Trading con IA: por qué en mi sistema el backtest decide y el LLM solo veta
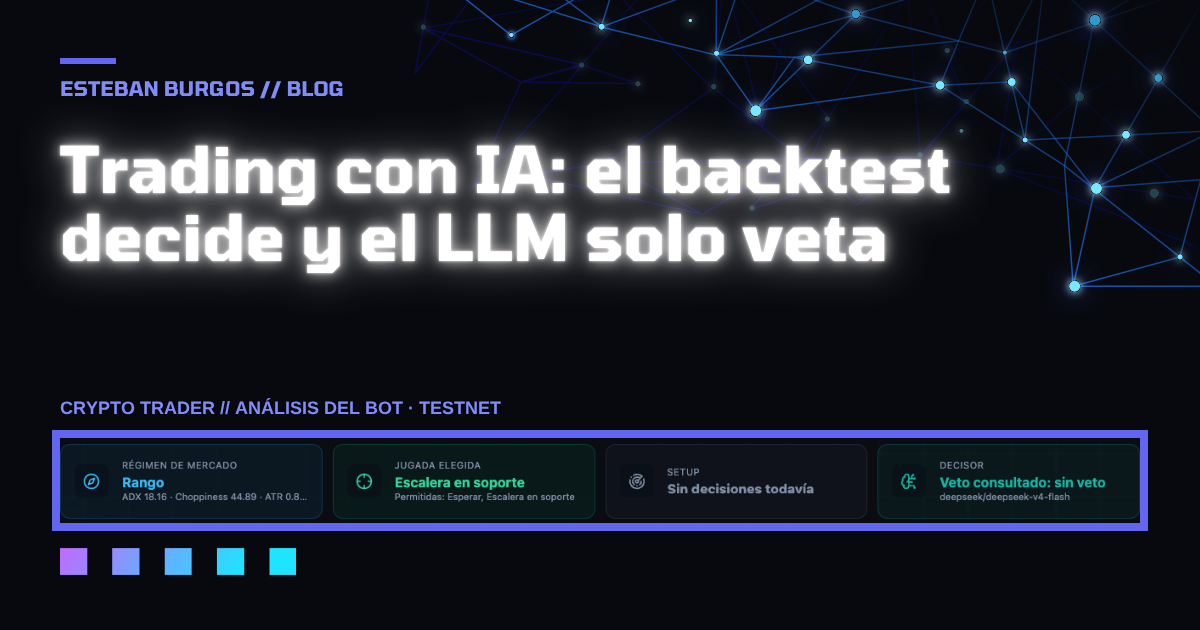
Cuando alguien me pregunta "¿el LLM decide cuándo comprar o vender?", mi respuesta es siempre la misma: no. Y esa decisión de diseño es, para mí, lo que separa un sistema de trading confiable de un experimento difícil de auditar. Soy Esteban Burgos, Forward Deployed Engineer, y en este post comparto cómo diseñé Crypto Trader, mi sistema multi-agente para operar BTC y ETH en Binance, con modos sandbox, testnet y live. No voy a publicar saldos, posiciones ni resultados de trading —esa información no sale de mi entorno—, pero sí puedo contar el diseño, que puede servirle a otros equipos que estén evaluando incorporar IA en sistemas de decisiones económicas.
El problema de dejar que un LLM "decida"
Los LLM son muy buenos para razonar sobre contexto ambiguo, sintetizar información dispersa y detectar patrones que una regla rígida no anticipó. Pero un modelo de lenguaje no tiene, por diseño, garantías de determinismo, ni un historial verificable de qué tan bien se comportó esa decisión específica en el pasado. Cuando lo que está en juego es dinero real, esa falta de trazabilidad es un riesgo que decidí no asumir como fuente primaria de decisión.
Por eso en Crypto Trader invertí el orden habitual: la decisión de operar (entrar, salir, ajustar tamaño) nace de reglas calibradas por backtest. El LLM entra después, con un rol acotado: puede vetar una operación si detecta una señal de riesgo que la regla no capturó, pero no puede inventar una operación que el backtest no habilitó.
Las reglas calibradas por backtest, la fuente de la decisión
El corazón del sistema es un motor de backtest de aproximadamente 6.900 líneas que corre sobre velas reales, no sobre datos sintéticos ni sobre simulaciones idealizadas. Cada regla que termina operando en testnet o en live pasó antes por ese motor, que mide su comportamiento histórico con datos de mercado efectivamente ocurridos.
Lo desarrollé siguiendo Spec-Driven Development (SDD): documenté 12 specs que definen el comportamiento esperado de cada componente del motor y del sistema de agentes, y a lo largo del proceso registré 73 fixes derivados de esas specs. Cada fix quedó atado a una spec concreta, lo que significa que cuando algo se corrige, queda evidencia de por qué se corrigió y qué comportamiento se esperaba en su lugar. Esa trazabilidad me permite sostener, con evidencia, que una regla está calibrada y no simplemente "se ve bien en el gráfico".
La consecuencia práctica es que el LLM nunca es la fuente de la señal de entrada o salida. La señal viene de una regla que ya mostró, sobre datos reales, un comportamiento medible. El LLM opera sobre esa señal, no la reemplaza.
Ocho roles de agente, un modelo por puntaje
Crypto Trader no es un solo prompt gigante disfrazado de "IA de trading". Es un sistema con ocho roles de agente, cada uno con una responsabilidad acotada: análisis de mercado, evaluación de riesgo, validación de la señal contra el backtest, verificación de contexto de noticias u eventos relevantes, control de exposición y tamaño de posición, auditoría de cumplimiento de las reglas, monitoreo de ejecución en Binance, y el rol de veto final antes de que una orden salga hacia sandbox, testnet o live.
Separar responsabilidades en roles distintos tiene una ventaja concreta: cada agente puede evaluarse de forma independiente. Y ahí entra algo que considero central en el diseño: el modelo que ejecuta cada rol se elige por puntaje, no por preferencia ni por moda. Cada rol tiene un criterio de evaluación propio —precisión en su tarea específica, consistencia de salida, costo, latencia según lo crítico que sea el rol— y el modelo que mejor puntúa en ese criterio es el que queda asignado a esa función. Un rol de auditoría de cumplimiento no necesita el mismo perfil que un rol de análisis de contexto de mercado, y forzar un modelo único para las ocho tareas es, en mi experiencia, una simplificación que termina costando calidad de decisión.
Esta arquitectura de roles con modelos elegidos por puntaje también me da flexibilidad hacia adelante: si aparece un modelo que puntúa mejor en el criterio de un rol específico, lo reemplazo en ese rol sin tocar el resto del sistema. El diseño multi-agente no es estética, es la forma en que mantengo el sistema evaluable componente por componente.
Gates de riesgo y verificación en testnet antes de producción
Ningún cambio de regla ni ningún ajuste de modelo llega a operar con dinero real sin pasar antes por gates de riesgo explícitos y por verificación en testnet. El flujo que sigo es siempre el mismo: sandbox para validar lógica sin exposición real, testnet de Binance para validar ejecución contra un entorno de mercado real pero sin capital en riesgo, y solo después, si los gates de riesgo se cumplen, el paso a modo live.
Los gates de riesgo son justamente donde el LLM ejerce su poder de veto: si un agente de riesgo detecta una condición fuera de los parámetros esperados —aunque la regla calibrada por backtest indique operar—, la operación se frena. El LLM no necesita "inventar" una alternativa ni proponer una operación distinta; su función es exclusivamente negativa: bloquear cuando algo no cierra. Esa asimetría —la regla propone, el LLM solo puede vetar, nunca agregar— es, para mí, la clave para sumar el criterio de un modelo de lenguaje sin heredar su falta de determinismo en la decisión final.
Por qué puede interesarle a equipos fintech
Para un equipo que esté evaluando incorporar agentes de IA en un sistema que mueve dinero, una pregunta útil puede ser no tanto "qué tan inteligente es el modelo", sino "quién tiene la autoridad de decidir, y con qué evidencia llegó ahí". En mi caso, la autoridad la tiene una regla validada contra un motor de backtest de unas 6.900 líneas sobre velas reales, documentada con SDD a través de 12 specs y 73 fixes trazables. La IA suma criterio en ocho roles especializados, cada uno con su modelo elegido por puntaje, y su única palanca sobre la operación final es el veto, ejercido a través de gates de riesgo verificados primero en sandbox, después en testnet, y solo entonces en producción.
Qué me llevo
- Definir quién tiene la autoridad de decidir (acá, la regla validada por backtest) es una decisión de diseño previa a elegir cualquier modelo.
- Una IA con poder de veto, y no de propuesta, suma criterio sin heredar la falta de determinismo en la decisión final.
- Separar el sistema en roles acotados permite evaluar y reemplazar cada modelo por puntaje sin tocar el resto.
- Atar cada fix a una spec deja evidencia de por qué se cambió algo y qué comportamiento se esperaba.
- Sandbox, testnet y gates de riesgo antes de producción son un recorrido que no me conviene saltear.
Cierre
Es un diseño en el que sigo aprendiendo y ajustando. Si estás trabajando en algo parecido, o tu equipo está evaluando cómo incorporar IA en decisiones críticas, me interesa intercambiar experiencias: podés escribirme por LinkedIn. También cuento cómo aplico este enfoque en proyectos en mi web.
Sobre el autor
ESTEBAN BURGOS · Tech Lead Frontend · Ingeniero de soluciones de punta a punta
Construyo software de punta a punta para pymes y empresas: webs, plataformas y soluciones con IA. Escribo sobre lo que aprendo en proyectos reales.
Conocé mi trayectoria¿Querés algo así en tu empresa?
Contale tu idea a Tuki y en minutos tenés un rango de precio en tu moneda.
Seguí leyendo
- Lecciones de construir una plataforma de trading para una empresa de energía: seguridad, tiempo real y backofficeComo Forward Deployed Engineer participé, junto a un equipo, en una plataforma de inversiones y trading para una empresa del sector energía con su backoffice de operaciones. Comparto aprendizajes de arquitectura y de proceso, sin código ni datos internos.
- SDD en la práctica: la plantilla de spec que uso con agentes de IALa plantilla de spec que uso a diario con agentes de IA, con el porqué de cada sección: resumen, criterios de aceptación y los gates que evitan que el código avance sin especificación. También cómo elijo entre flow lite y full y por qué registro el consumo de tokens.
- Migrar a bilingüe con hreflang y SDD: la guía que me hubiera ahorrado tres bugs de SEOCómo migré un sitio a bilingüe (ES/EN) con rutas app/[lang], rewrites de proxy y hreflang recíprocos sin romper URLs indexadas, y cómo un ciclo SDD con plan, tasks y verificación en producción ayudó a contener las trampas del camino.
Comentarios
Sé el primero en comentar.