Migrar a bilingüe con hreflang y SDD: la guía que me hubiera ahorrado tres bugs de SEO
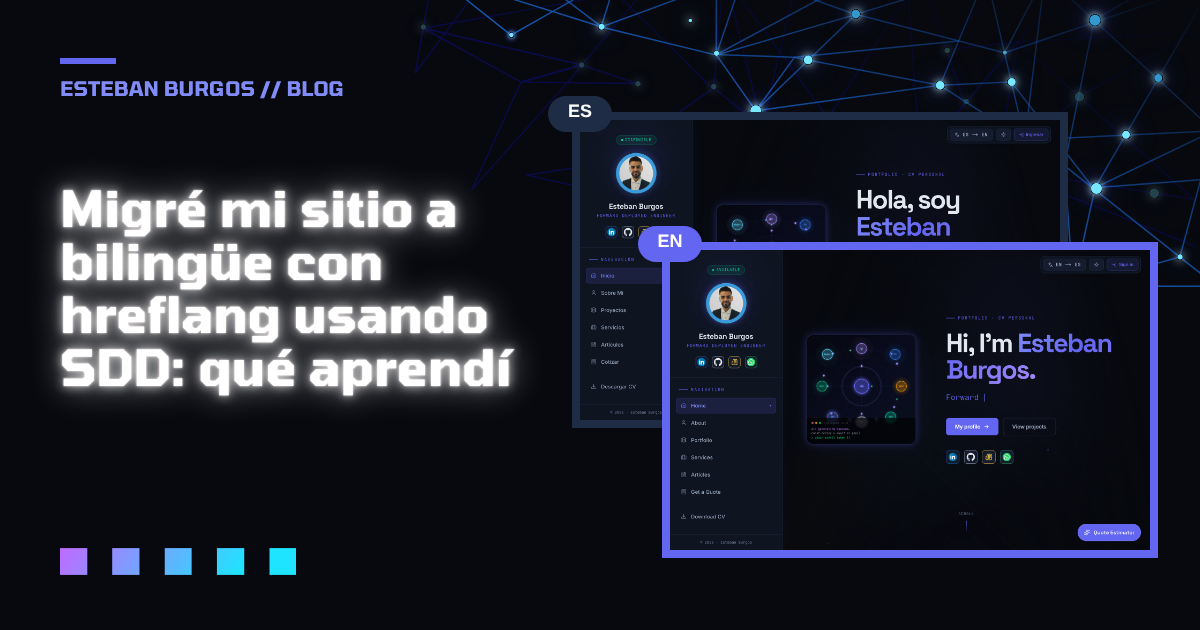
Hace unas semanas terminé de migrar un sitio que tenía el contenido mezclado dentro del mismo HTML —literalmente, párrafos en español seguidos de fragmentos en inglés que venían de componentes distintos según qué parte del store estuviera hidratada primero— a una estructura bilingüe real, con rutas separadas, hreflang recíprocos y sitemap con alternativas. En este artículo cuento cómo lo encaré en mi rol de Forward Deployed Engineer: qué salió mal, qué decisiones tomé y por qué trabajar con SDD (spec, plan, tasks, verificación) me ayudó a no romper el posicionamiento que el sitio ya tenía.
No es un tutorial genérico de i18n: comparto lo que efectivamente pasó, en el orden en que pasó, por si puede servirle a otros equipos en una situación parecida.
El punto de partida: un HTML que no sabía en qué idioma estaba
El síntoma que arrancó todo esto era simple de describir y difícil de diagnosticar: algunas cargas de página mostraban el hero en español y el footer en inglés. Otras, al revés. No era un problema de traducción faltante, era peor: el servidor estaba renderizando con un store global que se poblaba de forma asíncrona y no garantizaba que todos los componentes leyeran el mismo idioma en el mismo render.
Una conclusión que me quedó de esto: los problemas de i18n rara vez son "falta una traducción". Casi siempre son problemas de cuándo y dónde se decide el idioma, y si esa decisión es consistente durante todo el ciclo de vida del render.
Antes de tocar una sola línea de componente, escribí la spec: qué comportamiento tenía que tener el sitio en cada idioma, qué URLs iban a existir, qué pasaba con las que ya estaban indexadas. Esa spec se convirtió en un plan con tasks concretas, y cada task tenía un criterio de verificación explícito. No lo hice por burocracia: cuando se tocan rutas que Google ya indexó, cada cambio sin verificar es un riesgo real de tráfico perdido.
Rutas bajo app/[lang]: estático primero, siempre
La decisión de arquitectura fue mover todo el contenido a rutas bajo app/[lang]/..., usando generateStaticParams para que cada combinación de idioma y página se generara como HTML estático en build time, no en cada request.
Esto importaba por dos razones. La primera es performance: no quería introducir detección de idioma en runtime que forzara SSR dinámico en páginas que antes eran estáticas. La segunda es previsibilidad: si generateStaticParams devuelve explícitamente las combinaciones ['es', 'en'] para cada slug, no hay ambigüedad posible sobre qué versión existe y cuál no. El build falla si falta una traducción, en lugar de fallar silenciosamente en producción con un fallback raro.
En la práctica, esto significó reestructurar el árbol de rutas para que cada página tuviera su propio archivo de contenido por idioma, y que generateStaticParams leyera esa lista de contenidos disponibles en lugar de asumir que todo estaba traducido. Cualquier página sin su par en el otro idioma quedaba afuera del build para ese idioma, en vez de mostrar contenido a medias.
Español en la raíz: el rewrite que evitó romper URLs indexadas
Esta es la parte que más problemas me hubiera dado sin la spec previa. El sitio ya tenía años de historia en español, indexado en la raíz (/, /articulo-x, sin prefijo de idioma). Si migraba todo a /es/... y /en/... de forma literal, rompía cada URL que Google ya conocía. Eso no es un detalle: es tráfico orgánico existente puesto en riesgo por una decisión de arquitectura.
La solución fue mantener el español como el idioma "default" visible en la raíz, sin prefijo, y resolver esa ambigüedad en el proxy con un rewrite: internamente, cualquier request a /articulo-x se reescribe hacia /es/articulo-x para que el router de la app lo resuelva contra la estructura app/[lang], pero la URL pública, la que ve el usuario y la que indexa Google, sigue siendo /articulo-x. El inglés sí vive con prefijo explícito: /en/articulo-x.
Esto quiere decir que [lang] como segmento de ruta existe siempre a nivel de aplicación, pero no siempre existe a nivel de URL pública. El rewrite en el proxy es la capa que traduce entre esas dos realidades. Fue una de las tasks del plan que más tiempo de verificación necesitó, porque un rewrite mal configurado no rompe en desarrollo —rompe en producción, con cachés de CDN de por medio, y ahí ya es tarde.
Por qué no detecté el idioma del navegador (y por qué casi lo hago)
La tentación obvia acá es usar Accept-Language o alguna detección de idioma del navegador para redirigir automáticamente a cada visitante a su idioma preferido. Lo consideré en el plan inicial y lo descarté, y la razón es concreta: Googlebot navega en inglés. Si el sitio detecta el idioma del navegador y redirige en base a eso, el crawler ve consistentemente la versión en inglés, sin importar qué URL le pediste que rastree. Eso rompe la posibilidad de que Google indexe correctamente la versión en español de cada página, porque nunca la ve tal como es: siempre la ve redirigida.
Esto no es una particularidad de un bot específico sino un patrón general: cualquier lógica de idioma basada en headers de request en lugar de en la URL misma introduce una divergencia entre lo que ve un crawler y lo que ve un usuario humano con su navegador configurado en otro idioma. Y esa divergencia es exactamente lo que hreflang está diseñado para evitar, no para generar.
La decisión final fue que el idioma se determina exclusivamente por la URL solicitada, punto. Sin heurísticas, sin negociación de contenido, sin JavaScript client-side redirigiendo después del primer render. Cada URL es una fuente de verdad fija sobre en qué idioma está ese contenido, y esa fue justamente la garantía que necesitaba para que hreflang funcionara de forma confiable.
El store global que mezclaba idiomas: la trampa que no se veía en el código
Esta fue la parte más incómoda de diagnosticar, y la razón por la que valió la pena tener tasks de verificación explícitas en el plan, no solo tasks de implementación.
El store global de la app —el que maneja estado de UI, tema, algunas preferencias— tenía también una referencia al idioma actual, poblada en un efecto que corría después del render inicial. En cliente esto era invisible: para cuando el usuario veía algo, el store ya estaba consistente. Pero en el HTML generado en servidor, distintos componentes podían renderizar en momentos donde el store todavía no había terminado de poblarse con el idioma correcto, o donde una request concurrente había dejado el store con el idioma de otra request anterior si algo compartía estado entre renders de forma indebida.
La solución no fue "arreglar el store", fue eliminar esa dependencia: el idioma dejó de vivir en un store global y pasó a derivarse directamente del segmento [lang] de la ruta en cada componente que lo necesitara, vía el contexto de servidor de cada request, sin estado compartido entre renders. Ningún componente de servidor debía preguntarle al store "¿en qué idioma estamos?": debía recibirlo como parte de los datos de esa request específica.
Es, en mi experiencia, el tipo de bug que un ciclo SDD ayuda a atrapar mejor que un desarrollo ad hoc: la task de verificación decía explícitamente "renderizar 20 requests concurrentes en ambos idiomas y confirmar que el HTML de cada una corresponde a su idioma solicitado". Sin ese criterio escrito de antemano, es fácil dar por sentado que "ya funciona" con una sola carga manual en el navegador, que es justo el escenario donde el bug no se manifestaba.
Canonical, hreflang recíprocos y el sitemap con alternativas
Con las rutas resueltas y el idioma ya determinístico por URL, el resto fue implementar correctamente las señales para buscadores:
- Cada página en español declara su propio
canonicalapuntando a su URL sin prefijo, y unhreflang="en"apuntando a su equivalente en/en/.... - Cada página en inglés hace lo simétrico:
canonicala su propia URL con prefijo, yhreflang="es"apuntando de vuelta a la versión sin prefijo. - Agregué
hreflang="x-default"apuntando a la versión en español, porque es la que vive en la raíz y la que tiene el historial de indexación más largo.
El punto no negociable acá es que los hreflang tienen que ser recíprocos: si la página en español declara que su par en inglés es una URL X, esa URL X tiene que declarar de vuelta que su par en español es la URL original. Un hreflang no recíproco es, para efectos prácticos, ignorado por Google. Esto se verificó como una task separada del plan, iterando sobre cada par de páginas y confirmando la reciprocidad de forma automatizada, no leyendo el HTML a mano.
El sitemap se generó incluyendo las etiquetas de alternativas de idioma por cada entrada, no como dos sitemaps separados sino como un único sitemap donde cada URL lista sus alternativas correspondientes. El resultado final, después de toda la migración, fue un sitemap con 32 URLs: 5 páginas y 11 artículos, cada uno en sus dos idiomas.
Por qué el ciclo SDD importó acá
Ninguna de estas trampas —el rewrite mal calculado, la detección de idioma por navegador, el store global mezclando idiomas, el hreflang no recíproco— es exótica. Son errores conocidos en cualquier proyecto de i18n. Lo que cambió el resultado no fue conocer la teoría de antemano (en varios casos la descubrí en el camino), sino haber estructurado todo el trabajo como un ciclo con spec, plan, tasks y verificación explícita en producción, en lugar de ir implementando y probando manualmente a medida que avanzaba.
Cada task tenía un criterio de éxito escrito antes de tocar código, y ese criterio se verificaba contra producción real, no contra un entorno local que no replica cachés de CDN, rewrites de proxy ni comportamiento de crawlers. Eso fue lo que permitió detectar, por ejemplo, que el store global funcionaba "bien" en desarrollo pero fallaba bajo concurrencia real, o que un rewrite que parecía correcto en local se comportaba distinto detrás de la capa de proxy en producción.
La migración terminó, en números concretos, pasando de un HTML con idiomas mezclados e indexación ambigua a un sitio con 32 URLs bilingües bien declaradas en el sitemap, cada una con su canonical y su hreflang recíproco correspondiente. Todo el trabajo, de punta a punta, se hizo dentro de un solo ciclo SDD, con verificación en producción como parte no opcional del proceso.
Qué me llevo
- Los problemas de i18n suelen ser de cuándo y dónde se decide el idioma, no de traducciones faltantes.
- Que el idioma dependa únicamente de la URL hace que el comportamiento sea predecible para usuarios y crawlers.
- Escribir la spec y los criterios de verificación antes de tocar código me ayudó a proteger las URLs ya indexadas.
- Verificar contra producción real detectó problemas que el entorno local no mostraba.
- Varias de estas trampas las descubrí en el camino: tener un proceso que obliga a verificar fue lo que las contuvo.
Si estás trabajando en algo parecido, como rutas bilingües, hreflang o migraciones que no pueden romper URLs indexadas, me interesa intercambiar experiencias: podés escribirme por LinkedIn. Si te sirve, en mi portfolio cuento cómo trabajo este tipo de proyectos: https://estebanburgos.com.ar/portfolio.
Sobre el autor
ESTEBAN BURGOS · Forward Deployed Engineer
Construyo software de punta a punta para pymes y empresas: webs, plataformas y soluciones con IA. Escribo sobre lo que aprendo en proyectos reales.
Conocé mi trayectoria¿Querés algo así en tu empresa?
Contale tu idea a Tuki y en minutos tenés un rango de precio en tu moneda.
Seguí leyendo
- De IA suelta a desarrollo agéntico: cómo adoptamos SDD en un equipo de YPFCómo propuse adoptar Spec-Driven Development en un equipo de desarrollo de YPF y lo implementamos juntos: specs, ciclos, agentes por rol y gates, qué flows usamos según el tamaño del cambio y qué aprendimos.
- Cómo construí Tuki: el cotizador con RAG que ya está en producciónUn relato de primera mano sobre Tuki, el asistente de cotizaciones con RAG que corre en producción en estebanburgos.com.ar/quote. Cuento las decisiones de arquitectura, por qué elegí pgvector sin índice HNSW, cómo controlo costos con rate limiting y qué se rompió en el camino.
- Microfrontends en la Era Agéntica: Orquestación, SDD y la Belleza del Monorepo con NxDescubre cómo los microfrontends están transformando el desarrollo de software en la era de los sistemas agénticos compartidos e impulsados por SDD. Exploramos la flexibilidad de construir interfaces como apps independientes o como apps acompañadas de sus BFFs en un monorepo, la orquestación con Nx y la eficiencia del código compartido mediante librerías: un paradigma que vale la pena admirar.
Comentarios
Sé el primero en comentar.