LangChain en 2026: la clave para chatbots inteligentes con RAG, herramientas y una UX imbatible
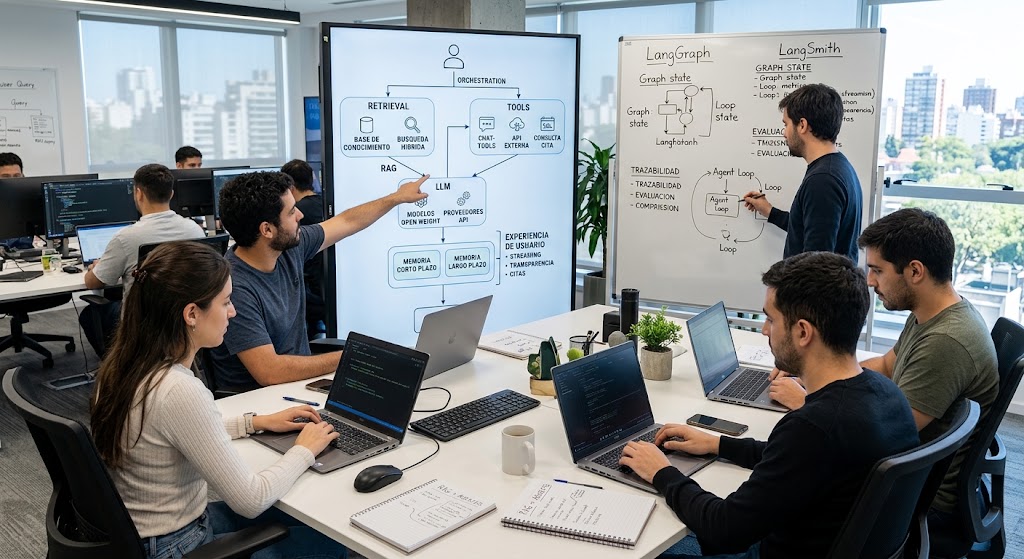
Si en los últimos años estuviste cerca del mundo de la inteligencia artificial generativa, seguramente escuchaste hablar de LangChain. No es un modelo de lenguaje, ni un producto cerrado, ni una API mágica que resuelve todo solo. Es un framework —hoy consolidado como estándar de facto— para orquestar todo lo que rodea a un modelo de lenguaje (LLM): recuperación de información, uso de herramientas externas, manejo de memoria, cadenas de razonamiento y, sobre todo, la lógica que convierte un modelo "que completa texto" en un asistente que realmente hace cosas.
En este artículo vamos a repasar qué es LangChain, por qué sigue siendo relevante en 2026, y cuál es la combinación ganadora para construir chatbots inteligentes: RAG (Retrieval-Augmented Generation), chat-tools (herramientas que el modelo puede invocar) y una experiencia de usuario que no frustre a nadie.
¿Qué es LangChain, exactamente?
LangChain es un framework open source (con SDKs en Python y JavaScript/TypeScript) pensado para construir aplicaciones sobre LLMs de forma modular. En lugar de escribir prompts sueltos y llamadas directas a una API como la de OpenAI, Anthropic o modelos open weight como Llama o Mistral, LangChain te da abstracciones para:
- Encadenar pasos de razonamiento (chains): por ejemplo, primero resumir un documento, después clasificarlo, y finalmente generar una respuesta.
- Conectar el modelo con fuentes de datos externas (retrievers, vector stores) para hacer RAG.
- Darle "manos" al modelo mediante herramientas (tools) que puede decidir invocar: buscar en la web, consultar una API interna, ejecutar código, escribir en una base de datos.
- Mantener memoria de la conversación, ya sea a corto plazo (la sesión actual) o a largo plazo (preferencias del usuario, historial).
- Orquestar agentes, es decir, sistemas donde el LLM decide qué pasos seguir y en qué orden, en lugar de seguir un flujo 100% predefinido.
Con el tiempo, el ecosistema se amplió con LangGraph, pensado específicamente para modelar estos flujos como grafos de estados —muy útil cuando el chatbot necesita lógica condicional, loops de verificación o múltiples agentes colaborando—, y LangSmith, la capa de observabilidad y evaluación que permite ver qué está pasando "adentro" del agente: qué prompt se generó, qué herramienta se llamó, cuánto tardó, dónde falló.
Esta separación entre "razonamiento del modelo" y "orquestación de la aplicación" es lo que convirtió a LangChain en una pieza tan usada: no importa qué LLM esté de moda este trimestre, la lógica de tu producto puede mantenerse relativamente estable.
Por qué un chatbot "solo con un LLM" ya no alcanza
Un modelo de lenguaje, por más potente que sea, tiene limitaciones estructurales:
- Conocimiento congelado: fue entrenado hasta cierta fecha y no sabe qué pasó en tu empresa la semana pasada.
- Alucina: cuando no sabe algo, muchas veces inventa una respuesta convincente en lugar de admitir que no tiene la información.
- No puede actuar por sí solo: no puede consultar tu base de datos, agendar una reunión o cobrar un pago sin que alguien le dé esa capacidad explícitamente.
- No tiene memoria persistente salvo que se la construyas.
Por eso, un chatbot "inteligente" de verdad no es solo un LLM con un prompt bien escrito. Es un sistema compuesto por al menos tres capas: recuperación de contexto (RAG), capacidad de acción (herramientas) y una capa de experiencia que hace que todo esto se sienta natural para la persona del otro lado.
RAG: la memoria externa del chatbot
RAG (Retrieval-Augmented Generation) es la técnica que resuelve el problema del "conocimiento congelado". En vez de confiar únicamente en lo que el modelo aprendió durante el entrenamiento, el sistema busca información relevante en una base propia —documentos, tickets de soporte, políticas internas, catálogos de productos— y se la inyecta al modelo como contexto antes de generar la respuesta.
El flujo típico con LangChain se ve así:
- Los documentos se dividen en fragmentos (chunking) y se convierten en embeddings.
- Esos embeddings se guardan en una base vectorial (Chroma, Pinecone, Weaviate, pgvector, entre otras).
- Cuando llega una consulta del usuario, se busca por similitud semántica los fragmentos más relevantes.
- Esos fragmentos se le pasan al LLM junto con la pregunta original, para que responda basándose en información real y verificable.
Lo interesante de RAG no es solo que reduce las alucinaciones: también permite citar fuentes, algo clave para generar confianza. Un chatbot que dice "según la política de devoluciones actualizada en marzo, tenés 30 días" es mucho más confiable que uno que responde con seguridad pero sin poder justificar de dónde saca esa información.
En 2026, las implementaciones de RAG maduraron bastante respecto a los primeros experimentos: es común combinar búsqueda semántica con búsqueda por palabras clave (búsqueda híbrida), aplicar re-ranking para priorizar los fragmentos realmente relevantes, y hasta usar RAG "agéntico", donde el propio modelo decide cuántas búsquedas hacer y con qué términos, en lugar de una única consulta fija.
Chat-tools: cuando el bot deja de solo hablar y empieza a hacer
Si RAG le da conocimiento al chatbot, las herramientas (tools) le dan capacidad de acción. Esto es lo que separa a un chatbot informativo de un asistente que resuelve tareas de punta a punta.
Con LangChain, definir una herramienta es relativamente directo: se describe qué hace, qué parámetros necesita, y el modelo —siguiendo el patrón de "function calling" o "tool calling" que hoy soportan de forma nativa modelos como GPT, Claude o Gemini— decide en tiempo real si necesita usarla y con qué argumentos.
Ejemplos típicos de chat-tools en un chatbot de producción:
- Consultar el estado de un pedido en el sistema de e-commerce.
- Verificar disponibilidad de horarios y agendar una cita.
- Ejecutar una búsqueda web para información en tiempo real.
- Generar un ticket de soporte en el sistema interno.
- Hacer cálculos o consultas SQL sobre una base de datos.
La clave está en que el modelo no ejecuta la acción directamente sobre el mundo real: decide qué quiere hacer, y es tu código el que valida, ejecuta y devuelve el resultado. Esto da control, seguridad y la posibilidad de poner capas de confirmación humana en acciones sensibles (como procesar un pago o cancelar una suscripción).
Acá es donde LangGraph brilla especialmente: permite modelar explícitamente flujos donde el agente puede necesitar varias herramientas encadenadas, pedir confirmación al usuario antes de ejecutar una acción crítica, o reintentar si una herramienta falla.
La UX: el ingrediente que casi siempre se subestima
Acá viene la parte que muchos equipos técnicos dejan para el final, y que sin embargo suele definir si un chatbot se siente "inteligente" o simplemente frustrante:
- Streaming de respuestas: nadie quiere mirar una pantalla en blanco 8 segundos esperando la respuesta completa. Mostrar el texto a medida que se genera cambia por completo la percepción de velocidad.
- Transparencia sobre lo que está pasando: si el bot está buscando en una base de conocimiento o llamando a una herramienta, mostrar un indicador ("Buscando en la documentación...", "Consultando el estado de tu pedido...") reduce la ansiedad de espera.
- Manejo elegante del "no sé": un buen chatbot admite sus límites en lugar de inventar. Decir "no tengo esa información, pero puedo derivarte con un agente humano" genera más confianza que una respuesta ambigua.
- Memoria conversacional coherente: que el bot recuerde lo que se dijo dos mensajes atrás en la misma sesión, sin pedirte que repitas todo.
- Salidas de emergencia claras: siempre tiene que existir un camino fácil hacia un humano cuando el bot no puede resolver algo.
- Citas y trazabilidad: mostrar de dónde viene la información (un link al documento, la fuente exacta) ayuda mucho a la confianza, sobre todo en contextos como soporte técnico, salud o finanzas.
Ninguna de estas cosas depende del modelo de lenguaje que elijas. Dependen de cómo diseñás la aplicación alrededor de él, y es exactamente el terreno donde LangChain (junto con LangGraph para el flujo y LangSmith para observar qué está pasando) aporta la estructura necesaria.
¿Cómo armamos todo esto en la práctica?
Un stack típico y realista en 2026 para un chatbot de este tipo se apoya en:
- Ingesta y procesamiento de datos: pipelines que toman documentos, tickets, FAQs o bases internas, los limpian, los dividen en chunks razonables y generan embeddings.
- Base vectorial + búsqueda híbrida: para recuperar contexto relevante combinando similitud semántica y coincidencia de palabras clave, con re-ranking cuando el volumen de documentos es grande.
- Orquestación con LangChain/LangGraph: el grafo de decisión define cuándo hacer RAG, cuándo llamar a una herramienta, cuándo pedir confirmación al usuario y cuándo simplemente responder.
- Capa de herramientas bien definida: cada tool con su esquema claro de entrada/salida, sus validaciones y sus límites de seguridad (rate limiting, permisos, sandboxing cuando ejecuta código).
- Modelo(s) de lenguaje: muchas implementaciones actuales usan más de un modelo según la tarea —uno más económico y rápido para clasificar intención, otro más potente para generar la respuesta final—, algo que LangChain facilita al abstraer el proveedor detrás de una interfaz común.
- Frontend con streaming y estados intermedios: la interfaz consume la respuesta token por token y muestra claramente cuándo el bot está "pensando", buscando o ejecutando una acción.
- Observabilidad y evaluación continua: con LangSmith (u otras herramientas de tracing) se revisan las conversaciones reales, se detectan fallas de RAG (fragmentos irrelevantes recuperados), errores en el uso de herramientas, y se ajustan prompts o la estrategia de retrieval en base a datos concretos, no solo intuición.
La combinación de estas capas es lo que realmente define la calidad final. Un chatbot con un modelo de última generación pero sin buen RAG va a alucinar. Uno con RAG perfecto pero sin herramientas se queda respondiendo preguntas sin poder resolver nada de forma proactiva. Y uno con todo eso técnico bien resuelto, pero con mala UX, termina generando más frustración que valor.
Conclusión
LangChain no es una bala de plata, pero sí ofrece el andamiaje necesario para no reinventar la rueda cada vez que se construye una aplicación sobre LLMs. La clave para un chatbot inteligente en 2026 no está en elegir el modelo más grande del mercado, sino en diseñar bien la orquestación: darle memoria externa confiable con RAG, capacidad de acción real con herramientas, y una experiencia de usuario que haga que todo ese trabajo técnico se sienta simple, transparente y humano. Cuando esas tres piezas encajan, el resultado deja de ser "un chatbot más" y se convierte en un asistente que la gente realmente quiere usar.
Comentarios
Sé el primero en comentar.